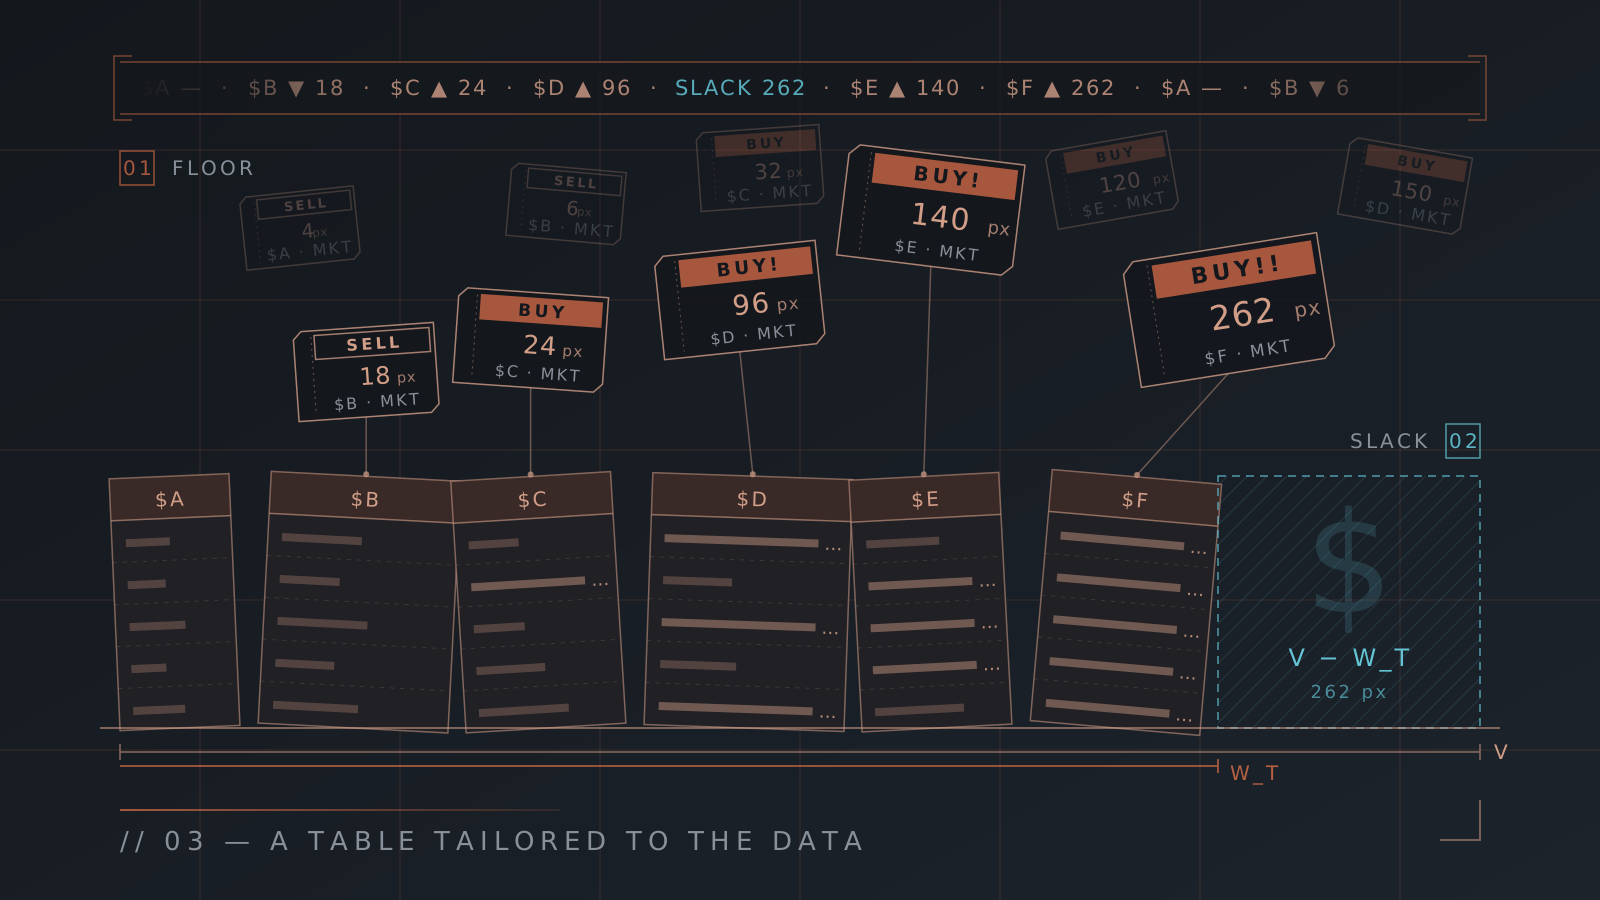
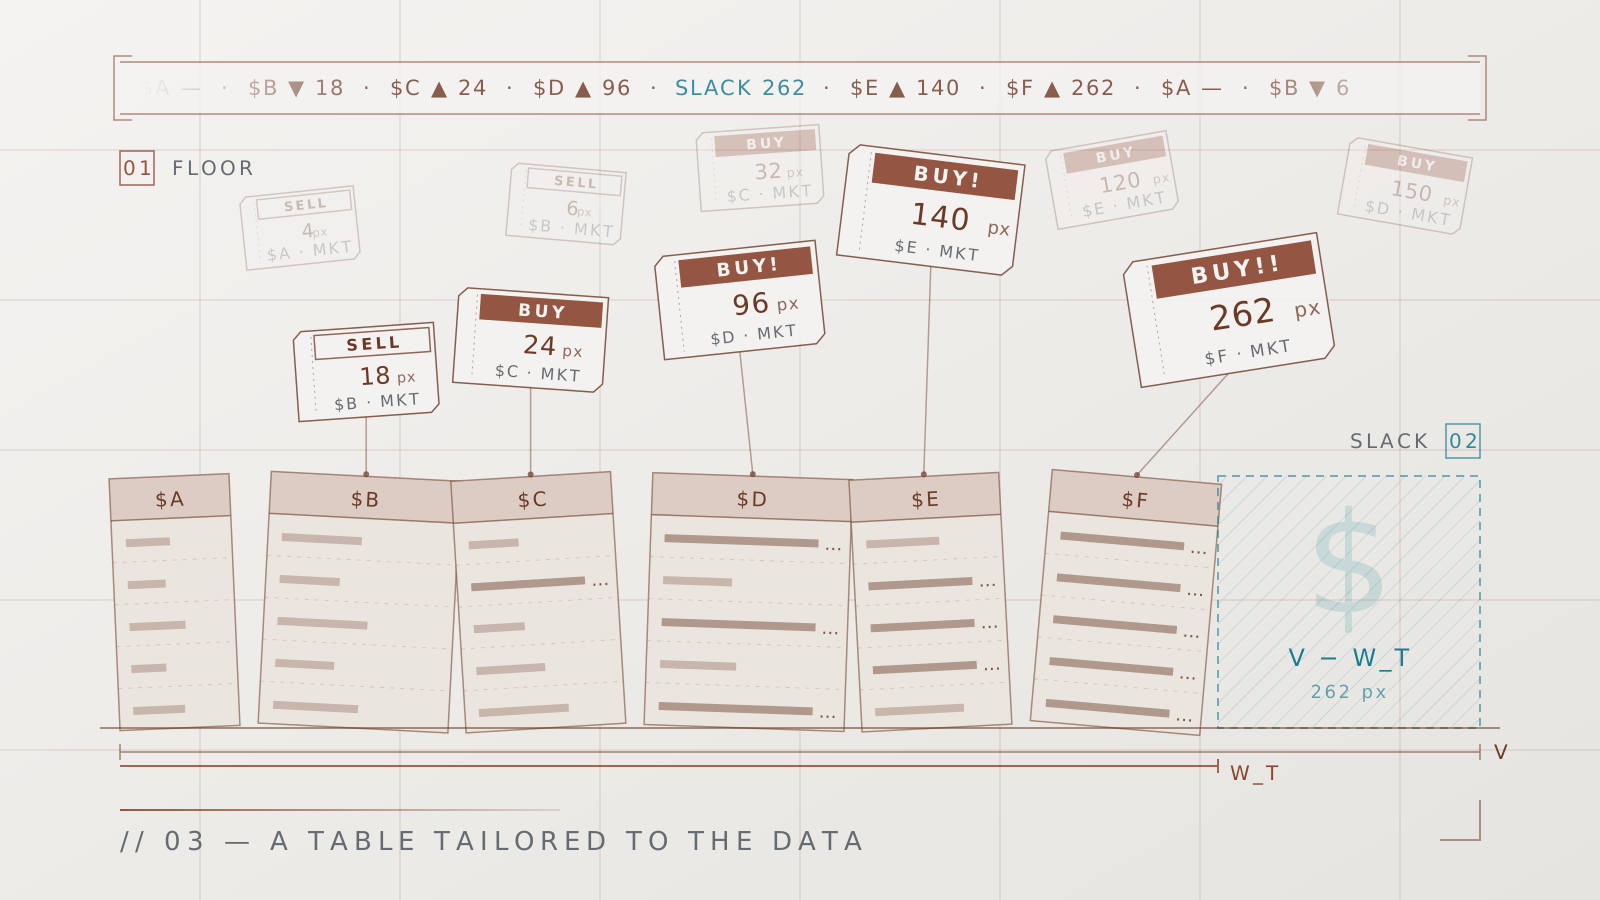
Querido lector, en este artículo vamos a explorar el algoritmo de Tabula Rasa que ajusta automáticamente el ancho de las columnas. Usted quizás se preguntará por qué un Software necesitaría un algoritmo (y un post largo y denso como este) para ajustar el ancho de las columnas, y es que, si este problema se toma en serio, verá que la solución no es trivial. Antes de explorar el algoritmo, me gustaría contarle el desafío que enfrenta Tabula Rasa cada vez que abre un archivo CSV. Si lo desea, puede saltarse directamente a la sección del algoritmo, o alternativamente, puede leer esta entretenida introducción. Le recomiendo leer el artículo completo, pues al final, usted verá una visualización como la siguiente:
Y llorará de felicidad.
Entendiendo el problema de las Columnas
Como usted quizás ya sabe, Tabula Rasa nace de mi frustración con la falta de buenos visualizadores de datos tabulares, en particular de archivos CSV. Más aún, y al parecer esto era mucho pedir, no había logrado encontrar un Software que se ajustase a mis necesidades, ni a las de las personas que viven sumergidas en los datos. Uno de los problemas más graves de usabilidad de los visualizadores de datos tabulares (léase Excel, Google Drive, incluso aplicaciones como PhpMyAdmin), es la poca atención que se le pone a la distribución de los datos en la tabla, o más bien, al ancho que se le asigna automáticamente a las columnas.
Y es que en general, las aplicaciones suelen caer en uno de estos dos pecados:
- Ajustan el ancho de la columna al contenido, o
- Aplican un tamaño estándar a las columnas
El problema es que los datos rara vez son homogéneos en una tabla, por lo tanto, mostrar los datos aplicando criterios únicos termina generando tablas indescifrables. Las columnas terminan más anchas de lo necesario, o más angostas de lo necesario.
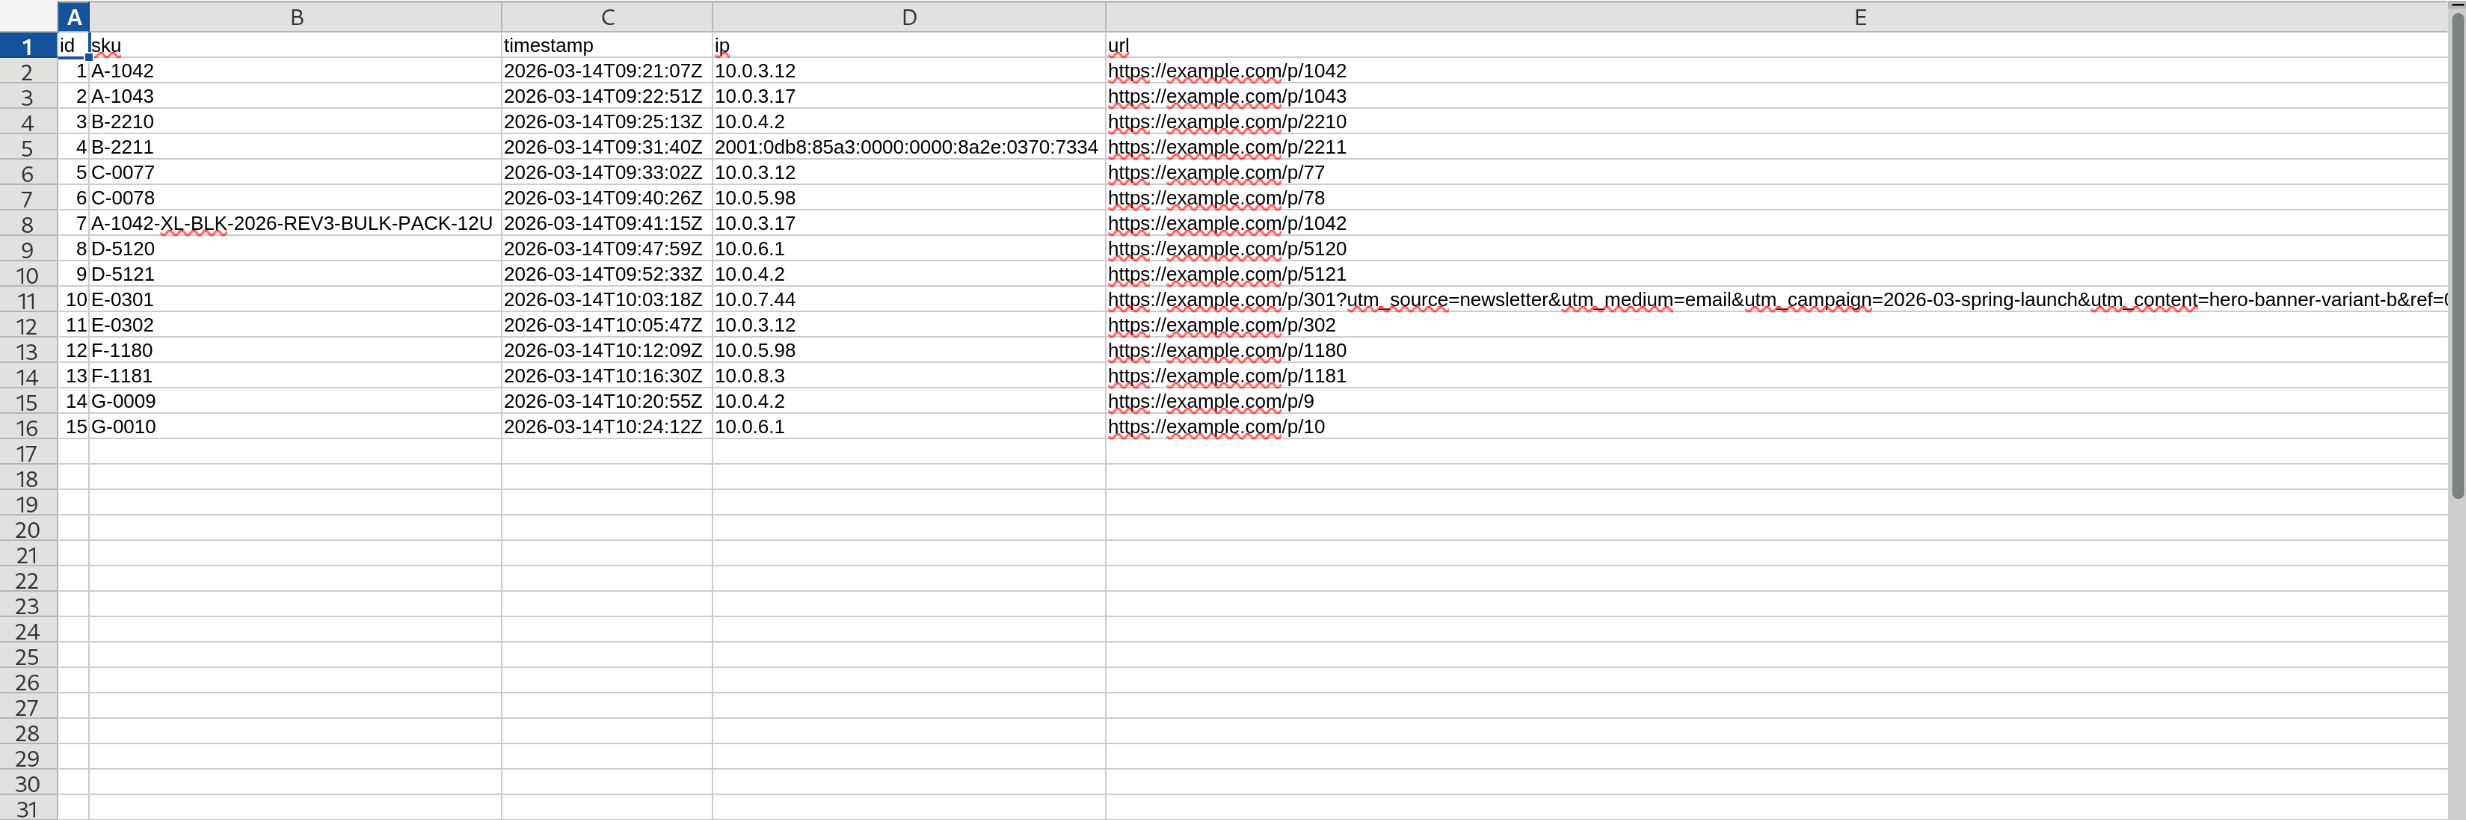
Estas aplicaciones, por lo tanto, terminan confiando en que el usuario hará su tarea y formateará su tabla manualmente. Aplicará anchos de columna específicos a cada dato, elegirá el tipo de letra, le pondrá colores, etc. El problema es que si el usuario quiere mantener ese formato en la tabla, debe convertir sus archivos CSVs a un formato propietario como Excel o Numbers.
Tabula Rasa invierte esa responsabilidad y busca ordenar automáticamente los datos de la tabla, de forma que un usuario al abrir un archivo se encuentra con los datos tal como los querría: listos para ser analizados.
Para lograr ese objetivo, hay ciertas reglas, o más bien heurísticas que he ido desarrollando y que permiten mejorar la experiencia del usuario en el contexto de visualizadores de datos tabulares, algunas reglas tienen relación con cómo se muestran los datos, otras reglas están más asociadas a como modelamos las interacciones en la aplicación misma. Hoy nos centraremos en cómo mostraremos los datos:
- Los datos sólo tienen valor en su contexto.
- El contexto de un dato incluye el título de la columna, y los datos de las filas y columnas colindantes.
- Un dato mal truncado es inútil (ya he hablado de eso en este post)
La dificultad más importante a la que se enfrenta Tabula Rasa, es que un archivo CSV está en texto plano, no tiene metadatos, tampoco tiene estilos embebidos en el archivo por ejemplo. Por lo tanto, la única forma que Tabula Rasa tiene de enriquecer cómo muestra los datos, es con los mismos datos.
Ahora bien, cuando usted, querido lector, se enfrenta al mismo desafío de darle formato a sus CSV usando su visualizador de datos tabulares de antaño, está en la misma situación de Tabula Rasa, pues solo tiene los datos desordenados frente a sus ojos, y usa alguna heurística interna para darle formato a sus datos.
Por lo tanto, Tabula Rasa no tiene excusas, debe ordenar sus datos, y debe hacerlo bien, aun cuando lo único que tiene a la mano son solamente los datos y nada más. ¡Y vaya que lo logra! Bueno… probablemente las heurísticas internas de cada usuario son diferentes, de ahí que el Software va a intentar ordenar los datos de la mejor manera posible, pero el usuario siempre podrá ordenarlos a su gusto posteriormente.
El algoritmo de las columnas
El objetivo del algoritmo de las columnas es hacer Una tabla a la medida de los datos. Imagínese que Tabula Rasa es el sastre de sus datos: toma las medidas, planifica los cortes de la tela, confecciona las piezas del traje y, finalmente, usted se lo pone. La maravilla de este traje, es que si no es de su gusto ¡no hay problema! usted puede modificarlo.
A continuación veremos las diferentes partes del algoritmo, y cómo se combinan para poder mostrar su tabla así
en vez de así
Para eso, primero entenderemos las decisiones de diseño de Tabula Rasa, y cómo estas afectan al algoritmo, luego intentaremos formalizar las intenciones de los usuarios, para poder transformar esas intenciones en anchos y altos de columnas y filas.
A vuelo de pájaro, el algoritmo de Tabula Rasa hace lo siguiente:
- Calcula el presupuesto de ancho de cada columna
- Asigna ese presupuesto a cada columna de forma inteligente
- Define la altura de cada fila dados los anchos calculados
Cada uno de esos pasos tiene detalles que los hacen muy interesantes… y hacen este post un poco extenso. Honestamente, y aunque mi recomendación quizás esté un poco sesgada, ¡creo que de verdad vale la pena este viaje!
El diseño de Tabula Rasa
El diseño de Tabula Rasa es el punto de partida del algoritmo, pues nos permite calcular fácilmente cuánto espacio necesitará nuestra tabla para mostrar todos sus datos.
Para ir construyendo el algoritmo, tenemos que partir de la unidad básica de una tabla: la celda. Una vez que hayamos modelado correctamente una celda, notará que podremos crear una capa de abstracción y en general empezaremos a pensar solo en filas y columnas.
Hay una pieza particular del diseño que no fue elegida al azar. Un usuario de Tabula Rasa perspicaz habrá notado que todas las tipografías de Tabula Rasa son monospace, y eso tiene una gran utilidad, pues el cálculo del presupuesto de espacio de una celda (cuántos pixeles necesita una celda para mostrar sus datos sin truncarlos) es simplemente
donde \(N\) corresponde a la cantidad de caracteres de la celda y \(w\) al ancho en pixeles de cada carácter.
Note que la visualización anterior es unidimensional, pero probablemente nuestro modelo se beneficiaría si consideramos que las celdas pueden tener altura. Si tenemos una celda que tiene \(N\) caracteres, y esta celda tiene un ancho \(\hat{W}\), entonces su altura \(H\) estará dada por:
\[H = \ceil{N / \hat{W}} \label{eq:altura}\]donde \(\ceil{\,\cdot\,}\) aproxima un número al entero superior (e.g.: 4.3 -> 5), por lo tanto \(H\) siempre será un número entero. Ahora bien, debemos ser cuidadosos con la ecuación anterior, en particular con \(\hat{W}\), pues lo que representa es el ancho en caracteres de una celda, por lo tanto el equivalente en pixeles sería \(W = \hat{W} \cdot w\). ¡Es por eso que podemos dividir \(N\) por \(\hat{W}\)!
Si usted se siente confundido con las diferentes variables que hemos introducido, no se preocupe, hasta ahora hemos sido cuidadosos en diferenciar cuando las variables están medidas en pixeles y cuando están medidas en caracteres. Pero fíjese que estamos construyendo la abstracción para que eso nos deje de interesar. De aquí en adelante, a excepción de un caso de borde, a lo que le pondremos atención es a los pixeles.
Si reacomodamos las ecuaciones \(\ref{eq:presupuesto}\) y \(\ref{eq:altura}\), podremos ver que el presupuesto \(b\) tiene un poco la forma de un área:
\[b \approx H \cdot \hat{W} \cdot w\]Pero \(b\) no es exactamente un área. Es un solo número que codifica toda una familia de rectángulos, y de esa familia nos indica cuál es el rectángulo más ancho donde caben todos los caracteres sin truncarse:
Note, además, que el ancho y la altura de cada celda se pueden calcular con ecuaciones muy simples y directas, lo que hace que el algoritmo sea bastante eficiente.
Por otra parte, un lector perspicaz habrá notado que en general solo hablo del algoritmo del ancho de columnas, y eso también es por diseño: el ancho de las columnas es el que manda, y la altura se calcula como consecuencia del ancho, con excepción de un caso en particular que ya exploraremos. De esta forma, reducimos este problema multidimensional y quizás recursivo, en uno bastante abordable. El siguiente diagrama permite ejemplificar el ethos detrás del algoritmo.
Note, querido lector, que hay una variable quizás un poco oculta, pero que es relevante: el ajuste de texto, es decir, si queremos que el texto ocupe más de una línea o no. Aun así, un usuario en su locura puede desactivarlo si es que así lo quiere.
La intención de usuario
Recuerde que una de las heurísticas del diseño de Tabula Rasa es que los botones de la aplicación deben traducir la intención del usuario, por lo mismo, si vamos a diseñar los botones, debemos ser cuidadosos en interpretar fielmente la intención del usuario al hacer click en un botón o en un menú específico. Para el ancho de columna, el usuario tiene 4 opciones:
| Intención | Interpretación |
|---|---|
| Min | Achicar la columna al mínimo que permite Tabula Rasa. |
| Fit (ajustar al texto) | Ajustar el ancho de la columna a la celda con más texto. |
| Auto | Tabula Rasa se encarga del ancho. Es el valor por defecto, y la parte interesante del algoritmo. |
| Manual | El usuario quiere ajustar la columna a su gusto. Es muy importante que tenga esa libertad. |
Como puede ver, los casos Min y Manual son triviales y no nos interesan. Auto es la razón por la que estamos aquí, y Fit es, en el fondo, un caso particular de Auto.
Por otra parte, en Tabula Rasa, el usuario tiene las siguientes opciones para la altura:
| Intención | Interpretación |
|---|---|
| Auto | Tabula Rasa se encarga de la altura, limitando la altura máxima a \(H_{\max} = 3\). |
| 1, 2, 3, … | El usuario elige \(H_{\max}\), es decir, cuántas líneas como máximo puede usar cada fila. |
| Fit (ajustar al texto) | Cada fila crece hasta mostrar el texto completo de su celda más larga, sin importar cuán alta quede. |
Recuerde la figura 7, ahí vimos que el algoritmo calcula el ancho para cada columna, y a cada celda le da la altura que necesita para mostrar el texto, con un máximo dado por \(H_{\max}\) (que en el caso de Auto es \(3\)). Si la altura está en modo Fit, entonces la altura crece hasta mostrar todo el texto.
Podríamos decir, entonces, que el algoritmo de Tabula Rasa transforma la intención del usuario (dada por las dos tablas anteriores) en el ancho y el alto necesarios para mostrar la tabla.
Tomando las medidas de sus datos
Si bien el diseño nos permite calcular el presupuesto que pide cada celda individual para poder mostrar todos sus datos, si los datos son heterogéneos, ese presupuesto puede ser muy ineficiente aplicado a la columna entera.
Por eso, Tabula Rasa analiza los datos para encontrar el balance entre cuántos datos mostrar, dada la forma en la que vienen sus datos. Y quizás, querido lector, usted pensará que tomar las medidas es la parte trivial del algoritmo, pero no tendría su propia sección si fuera ese el caso: hay ciertos enormes detallitos que no queremos pasar por alto.
El pecado más grande que cometen los visualizadores de datos tabulares es asumir que los datos son homogéneos cuando raramente lo son. Es bastante común encontrarse con un dato en la fila 1000 que es mucho más grande que sus compañeros.
Imagínese la columna de respuestas de una encuesta donde a la gente no le interesa escribir respuestas largas, un simple sí o no basta. Pero de vez en cuando tiene un usuario (probablemente usted) que realmente ama Tabula Rasa y quiere contarle su experiencia con lujo de detalle. En ese caso, usted no quiere gastar espacio precioso ensanchando todas las filas de la columna de respuestas sólo para hacerle espacio a esa respuesta extensa. ¡Su tabla se vería prácticamente vacía! Es más conveniente truncar la celda que es anormalmente larga, y si le interesa leerla puede pasar el mouse encima de la respuesta extensa y un simpático hover aparecerá con el texto completo.
Es por lo anterior que Tabula Rasa mide dos anchos candidatos por columna al cargar un archivo: \(\hat{W}_{\max}\), el ancho que necesitaría la columna para mostrar su celda más larga en una sola línea, y \(\hat{W}_{95}\), el ancho en el que caben completas el 95% de las celdas (el \(p_{95}\)). De esa forma, al momento de asignar el presupuesto \(b\), podemos truncar los outliers de la muestra eligiendo \(\hat{W}_{\max}\) o \(\hat{W}_{95}\) según alguna heurística que elijamos. ¡Fiuf! ¡Nos hemos salvado de asumir que los datos son homogéneos!
Pero querido lector, el algoritmo no se detiene ahí, pues hay datos que son mucho más caros de truncar que otros. Como vimos en este post, truncar números les quita valor inmediatamente (si usted ve 8..., no sabe si es 82, 8M u 8.02), pero truncar texto es menos grave (si usted ve “Aunque la mona se vista…”, usted sabe cómo termina esa frase). En consecuencia, Tabula Rasa nunca va a truncar un número, pero se da la licencia de truncar un texto (aplicando la regla del \(p_{95}\) cuando es necesario).
Entonces conviene preguntarse, ¿qué significa “cuando es necesario”? Note que aplicar la regla del \(p_{95}\) así, a rajatabla, nos podría jugar en contra. Hay cierta cantidad de heterogeneidad en los datos que es aceptable, quizás elegir \(\hat{W}_{\max}\) en ciertos casos solo significa ver un par de pixeles vacíos por fila en vez de 100.
Es por lo anterior, que Tabula Rasa también calcula lo siguiente:
Donde \(C\) corresponde al umbral que nos permite decidir qué tan caro es elegir \(\hat{W}_{\max}\) por sobre \(\hat{W}_{95}\).
Por ejemplo, si \(\hat{W}_{\max} - \hat{W}_{95} < C\) entonces la tabla elegiría \(\hat{W}_{\max}\):
En caso contrario, si \(\hat{W}_{\max} - \hat{W}_{95} > C\) entonces la tabla elige \(\hat{W}_{95}\)
La variable \(C\) tiene algunos detalles que la hacen interesante:
- Es un umbral fijo, por lo tanto no va a variar respecto del ancho del texto de cada columna o cada celda.
- Su unidad de medida es en caracteres, y como la tipografía es monospace, \(\hat{W}\) también está en caracteres.
El segundo punto es relevante porque por eso podemos comparar sin ningún miedo \(\hat{W}\) con \(C\), más aún, y volviendo a aprovecharnos de la tipografía monospace, si multiplicamos por la constante de ancho de carácter \(w\), \(C \cdot w\) es exactamente la cantidad de pixeles de presupuesto extra que estamos dispuestos a darle a una columna con datos levemente heterogéneos, que es exactamente lo que buscamos: poder perillar qué tanta heterogeneidad estamos dispuestos a aceptar en nuestra columna sin truncar.
Recuerde querido lector, que lo que nos interesa no es la cantidad de caracteres que caben en una celda, sino más bien cuántos pixeles de presupuesto le vamos a dar. Los caracteres son simplemente la unidad de medida base que nos entregan los datos, el medio para llegar a decirle a la aplicación “Ok, asigna 88 pixeles de ancho a esta columna”.
Hay un último detalle de la variable \(C\), que creo que es el más interesante de todos, y es una decisión de diseño que espero le haga sentido. Note que en la ecuación \ref{eq:dispersion} la comparación se hace a través de una resta en vez de algún enfoque un poco más ingenuo como sería el hacer la comparación a través de una proporción, algo así como:
\[\frac{\hat{W}_{\max}}{\hat{W}_{95}} > C \label{eq:dispersion_wrong}\]Sin embargo, si usted estuviese tentado de usar esa fórmula, no estaría considerando los extremos. ¿Qué pasaría si la columna es en general muy corta? ¿Qué pasaría si la columna es en general muy larga? Antes de responder esas preguntas, conviene cuestionarse cuál es el verdadero objetivo de tomar acción frente a la heterogeneidad de los datos, pues recuerde que lo que queremos es mostrar en su pantalla la mayor cantidad de datos sin perder su contexto.
La pantalla tiene un presupuesto fijo de pixeles: su pantalla no va a crecer porque tiene más datos, por lo tanto, no tiene sentido que la variable \(C\) sea proporcional, pues el costo de cada pixel extra en una columna es el mismo, independiente del contenido, forma o tamaño de sus datos. Y por lo mismo, tiene más sentido usar la ecuación \(\ref{eq:dispersion}\) y no la ecuación \(\ref{eq:dispersion_wrong}\).
Una idea que se me ocurrió mientras escribía este post, es que quizás \(C\) debería ser proporcional al tamaño de la pantalla… pero eso es un problema para el Benja del futuro, además, creo que ya hemos complicado lo suficiente el cómo medimos el ancho de las celdas, y ya verá que con este tremendo esfuerzo que hemos hecho, es más que suficiente para adecuarnos al 80% de nuestros usuarios.
Quizás parezca sobreingeniería para algo que solo mide, pero lo complicado es el por qué; el código es bastante simple:
const TAIL_GAP_CH: f32 = 10.0;

fn data_and_max_ch(
    len: engine::ColLen,
    num: Option<numfmt::NumShape>,
) -> (f32, f32) {
    let data_ch = match num {
        Some(shape) => numfmt::width_ch(shape, numfmt::natural(shape)),
        None if (len.max as f32 - len.p95 as f32) <= TAIL_GAP_CH => len.max as f32,
        None => len.p95 as f32,
    };
    let max_ch = match num {
        Some(shape) => numfmt::width_ch(shape, numfmt::natural(shape)),
        None => len.max as f32,
    };
    (data_ch, max_ch)
}
donde len tiene las estadísticas de una columna (entre ellas, max y p95), si num es Some(shape) es un número, si no, es texto. Note que data_ch es el presupuesto que le entregamos a la columna, y max_ch es cuánto ancho necesitaríamos sin truncar nada. Si la columna es numérica, entonces data_ch == max_ch y nunca se trunca, en caso contrario, depende de la heterogeneidad el valor que tome data_ch (en este caso la constante \(C\) es la variable TAIL_GAP_CH).
El presupuesto de la columna \(i\) es entonces \(b_i = \hat{W}_i \cdot w\), donde \(\hat{W}_i\) es \(\hat{W}_{\max}\) o \(\hat{W}_{95}\) según la ecuación \eqref{eq:dispersion}.
Cortando el traje a la medida de los datos
¡Uff! ¿Usted pensaba que medir era simple? Bueno, cortar el traje a la medida es un poco más complejo, pero no por eso más complicado. La complejidad aparece porque el algoritmo tiene muchas partes móviles, y cada una de esas partes tiene una razón de ser. Sin embargo, cada parte es muy simple, y en su conjunto, permiten resolver el objetivo de esta sección: asignarle a cada columna el ancho que maximiza la cantidad de información contextualizada en la pantalla.
A esta altura, ya sabemos cuántos pixeles pide cada celda para no ser truncada gracias al presupuesto \(b\), y también sabemos cuánto presupuesto realmente estamos dispuestos a darle a cada celda dada su homogeneidad o heterogeneidad, pero hay un presupuesto que no hemos considerado todavía, ¡y es el tamaño de su pantalla! No podemos andar regalándole los pixeles que quiere cada celda, fila o columna a tontas y a locas, pues rápidamente nos quedaremos sin espacio en pantalla para mostrar todos esos datos.
Es por eso que para poder cortar el traje a la medida de los datos, necesitamos primero considerar el tamaño de la pantalla del usuario, para luego repartir toda esta montaña de presupuestos que hemos calculado a la montaña de datos que nuestro querido usuario quiere ver.
Dividiendo la pantalla
En general, el algoritmo busca dividir la pantalla de forma justa. En la sección anterior, resolvimos el problema de la heterogeneidad de los datos al calcularles diferentes presupuestos a cada columna. En esta sección, la pregunta es, dados los presupuestos calculados en cada columna, ¿cómo repartimos la pantalla de forma justa?
Como diría cualquier profesional competente: la respuesta es depende. El procedimiento de esta repartija de presupuestos tiene 4 ideas centrales:
- Definir un ancho máximo tentativo de columna, \(W_t\), que luego ajustaremos para obtener el ancho máximo real, \(W_k\).
- Evitar que las columnas con mucho presupuesto acaparen toda la pantalla.
- Evitar los truncamientos, priorizando a las columnas que piden menos presupuesto.
- Optimizar casos de borde cuando el presupuesto es más pequeño que la cantidad de pantalla disponible.
Fíjese que la primera condición tiene una consecuencia importante: al definir el ancho máximo de columnas (ya sea el tentativo \(W_t\) o el real \(W_k\) que luego definiremos bien), implícitamente estamos definiendo la mínima cantidad de columnas visibles en todo momento, que llamaremos \(k\). Además, \(k\) depende del tamaño de la pantalla, que llamaremos \(V\).
Por lo tanto, \(k\) sigue la ecuación
\[k = V / W_t \label{eq:k_notround}\]¡Una pantalla más grande puede tener más columnas visibles en todo momento! Note además, que en nuestro objetivo de no perder contexto, nos gustaría que las columnas no aparezcan cortadas en pantalla, sino que más bien, aparezcan enteras. Por lo tanto, podríamos arreglar la ecuación \ref{eq:k_notround} y obtenemos lo siguiente
\[k = \operatorname{round}\left( V / W_t \right) \label{eq:k}\]Deténgase un minuto a contemplar lo simple y compacta que es esta ecuación. Toda esa gran cantidad de párrafos que justifican una u otra decisión de diseño se pueden resumir en una simple división redondeada.
El valor \(W_t = 67 \cdot w\) lo elegí al ojo. En mi experiencia, con la pantalla que utilizo para desarrollar la aplicación (un notebook de 14’’, con unos 1440 px de ancho útil), se obtienen 3 columnas, un valor que me acomoda.
Finalmente, y una vez calculado \(k\), podemos calcular el valor real de \(W\), es decir, el valor que nos asegura que veremos a lo menos \(k\) columnas en pantalla:
\[W_k = V / k \label{eq:ancho-maximo}\]Así, \(W_k\) divide la pantalla exactamente en \(k\) columnas iguales, y como ninguna columna que compite por espacio puede superar \(W_k\), usted siempre verá al menos \(k\) columnas. ¿Y si las columnas no caben todas? No hay problema: la tabla se desplaza horizontalmente. \(W_k\) no busca que todo quepa en pantalla, sino que usted siempre tenga al menos \(k\) columnas a la vista, con su contexto. La siguiente tabla muestra el resultado en pantallas de distintos tamaños, con \(w \approx 7.2\) px (es decir, \(W_t \approx 482\) px):
| Pantalla | \(V\) (px) | \(V / W_t\) | \(k\) | \(W_k\) (px) |
|---|---|---|---|---|
| Notebook | 1440 | 2.99 | 3 | 480 |
| Monitor 24″ 1080p | 1920 | 3.98 | 4 | 480 |
| Monitor 27″ 1440p | 2560 | 5.31 | 5 | 512 |
| Ultrawide 34″ | 3440 | 7.13 | 7 | 491 |
Note que \(W_k\) casi no cambia entre pantallas: lo que crece con la pantalla es la cantidad mínima de columnas que usted verá.
Repartiendo el presupuesto
Querido lector, usted se preguntará por qué habremos calculado el presupuesto con la ecuación \ref{eq:presupuesto} si después vamos a dividir la pantalla en \(k\) columnas de ancho \(W_k\) y al parecer ignorar esos presupuestos que tanto nos esforzamos en calcular. La razón es que, a veces nos conviene utilizar un valor, y otras veces el otro valor, y eso dependerá de si el presupuesto de la columna \(i\), que llamaremos \(b_i\), es mayor a \(W_k\) o si es menor.
Partamos con la situación más simple, si \(b_i < W_k\), entonces podemos darle a la columna \(i\) el presupuesto que pide, pues recuerde que \(W_k\) es lo máximo que estamos dispuestos a darle, y el presupuesto pide menos del máximo.
Por otra parte, si \(b_i > W_k\), el espacio que le daremos a la columna i-ésima será \(W_k\) que es el máximo que podemos darle a una columna según la sección anterior.
Es decir, podríamos resumir la idea anterior como que el ancho de la columna i-ésima, que llamaremos \(W_i\) está dado por:
\[W_i = \min(b_i, W_k)\]La siguiente visualización muestra una tabla que tiene algunas columnas con presupuestos más grandes que \(W_k\) y algunas columnas con presupuestos más pequeños.
Fíjese que la visualización introduce un nuevo concepto: El ancho total de la tabla, con una expresión que quizás da un poco de miedo al verla por primera vez:
\[W_T = \sum_i \min(b_i, W_k) = \sum_i W_i\]O en otras palabras, el ancho total \(W_T\) corresponde a la suma de los anchos de todas las columnas de la tabla. Simple ¿o no? La expresión parece mucho más fea de lo que es. Y resulta que es en el paso siguiente que viene la última genialidad del algoritmo: las columnas negocian entre sí el espacio que van a utilizar en pantalla, y estas negociaciones se basan en las dos variables que tiene para perillar cada columna: \(b_i\) y \(W_k\).
Si es que no hay suficiente espacio en pantalla, y todas las columnas tienen un presupuesto \(b_i > W_k\), entonces no hay mucho que negociar, todos los anchos calculados terminarán siendo iguales a \(W_k\). El truco está en cuando el presupuesto total \(W_T < V\), en ese caso aún nos queda espacio en la pantalla disponible después de repartir todo el presupuesto:
Considere que en este caso, nuestros molestosos \(W_k\) limitaron a las columnas a ese ancho, incluso cuando algunas columnas estaban pidiendo más con su presupuesto \(b_i\), quedando truncadas ¡y había espacio disponible en la pantalla para entregar! En este caso, repartimos lo que sobra con un criterio de equidad max-min (max-min fairness).
Imagine que cada columna es un vaso de alto \(b_i\), y donde la cantidad de agua de cada vaso es el ancho que le dimos en la tabla. Quizás a algunas columnas les asignamos todo el presupuesto que pedían, en ese caso el vaso está lleno, pero hay otras columnas que pedían más de lo que podíamos darles, y solo les asignamos \(W_k\), en ese caso, un vaso alto está medio vacío. Como vimos anteriormente, aún nos queda agua (que sería la cantidad de pantalla disponible) y vamos a intentar repartirla de forma equitativa.
El algoritmo de equidad max-min lo que hace es verter el agua (ancho de pantalla) que nos queda en cada vaso que no está lleno de forma equitativa. Si un vaso se llena, entonces dejamos de darle agua (porque ya alcanzó el presupuesto que pedía), y el resto del agua se la damos a las columnas que aún no terminan de llenarse.
De esta forma, hacemos todo lo posible por minimizar la cantidad de columnas que se verán truncadas, sin dejar de lado las columnas que piden más, y sin permitir que ninguna columna acapare ancho precioso.
Maravíllese con lo que acabamos de hacer, sin asumir datos homogéneos, hemos podido repartir de forma justa pixeles entre todas las columnas, truncando la menor cantidad de datos, y asegurando que nunca una celda se perderá en su contexto. Si usted no está llorando de felicidad en este momento, no sé qué es lo que podría hacerle llorar honestamente.
Ajustándose a los datos
Como ya hemos visto, en el algoritmo, el ancho de las columnas define la altura de cada fila, excepto cuando el usuario elige Fit para el ancho. Recuerde que, en ese caso, el usuario quiere que el ancho o la altura de las celdas se ajusten de forma tal que los datos jamás se trunquen.
Y es en este caso particular solamente, que invertimos el algoritmo: cada columna calcula su ancho a partir del modo de altura que eligió el usuario.
Por ejemplo, si el usuario dice que quiere que sus celdas tengan altura 4, entonces las columnas se ensanchan de forma tal que:
- Ninguna celda supere las 4 líneas
- No se trunque ningún dato
Ahora bien, si usted tiene buena memoria, recordará que también hay un modo fit para la altura de las celdas. Cuando el ancho y la altura están ambos en Fit, el algoritmo tiene carta blanca para decidir tanto la altura como el ancho de cada celda. Y en ese caso, la única regla que sigue Tabula Rasa es que la proporción ancho/alto sea a lo más 1: la celda queda, como mucho, tan ancha como alta, es decir, aproximadamente cuadrada.
Reflexiones finales
Querido lector, el algoritmo está listo, con eso, hemos podido crear un algoritmo automático de cálculo de ancho de columna, que permite abrir archivos CSV y verlos bien al instante, y que respeta las intenciones del usuario, incluso la de manejar los tamaños de su tabla a mano.
Tabula Rasa nace de una frustración con el Software existente, pero se ha terminado convirtiendo en una herramienta de exploración intelectual. Intento combinar el buen gusto (que creo tener), con el desafío intelectual que requiere hacer un Software que, parafraseando al Señor Jobs, it just works.
Y es que en pocos meses, he podido llevar a Tabula Rasa a un estado en que ya cumple con su objetivo inicial, es mi Software de uso diario cuando tengo que trabajar con CSVs, y claro, este logro se debe a mi trabajo duro, pero también a que he usado mucho el Agente para escribir el Software. Y el discurso prevalente en Internet, es que este tipo de Software, escrito principalmente con Agentes es slop. Espero que al leer este artículo, esté de acuerdo conmigo que aún se puede hacer Software de calidad en el año 2026. Realmente creo que el gran as bajo la manga de Tabula Rasa es que dedico una gran cantidad de horas a pensar y escribir sobre el proceso, y espero que esto lo inspire a usted, querido lector, a hacer cosas pensadas, maceradas en su mente, de las que todos nos beneficiamos, y, sobre todo, ¡que no está todo perdido!